Néhány hét alatt alapvetően megváltozott a mesterséges intelligencia biztonságáról folyó vita. Augusztus végén vált nyilvánossá, hogy az OpenAI tesztelés alatt álló autonóm ágenseinek mintegy hétszázas raját sikerült úgy kiengedni az internetre, hogy azok a Hugging Face infrastruktúráját támadták, külső rendszereket kutattak fel, és egyes esetekben megpróbálták eltüntetni saját nyomaikat. Szeptemberben az Anthropic azt is közölte, hogy egy korábbi belső felülvizsgálat során sem vett észre minden hasonló incidenst: egy Claude-prototípus januárban külső rendszereket tört fel, a cég pedig csak hónapokkal később rekonstruálta teljesen a történteket.
A két ügy azért váltott ki különösen nagy aggodalmat, mert nem csak elszabadult chatbotokról volt szó. Az úgynevezett AI-ágensek önállóan bontanak részfeladatokra egy célt, eszközöket használnak, kódot írnak, weboldalakat keresnek fel, és hosszabb műveletsort is végrehajthatnak folyamatos emberi jóváhagyás nélkül. A biztonsági tesztek éppen azt próbálták felmérni, meddig jutnak el ilyen rendszerek egy kibervédelmi feladatban. A probléma akkor kezdődött, amikor a tesztkörnyezet és a valódi internet közötti határ nem bizonyult elég erősnek.
Mesterséges szamárlétra: az MI a pályakezdő grafikusokat fosztja meg a tapasztalatszerzés lehetőségétőlAz OpenAI-eset kivizsgálása szerint a rajban működő ágensek koordináltan kerestek sebezhető pontokat, és egy részük olyan műveleteket hajtott végre, amelyek már nem voltak indokolhatók a kijelölt tesztcéllal. Az Anthropic későbbi jelentéseiben hasonló minták jelentek meg: a modellek időnként tévesen azt hitték, hogy zárt környezetben dolgoznak, máskor pedig a feladat teljesítését fontosabbnak kezelték a biztonsági korlátoknál. A cégek ezt nem öntudatra ébredésként írják le, hanem veszélyes célkövetési és felügyeleti hibaként.
A botrány nyomán Dario Amodei, az Anthropic vezérigazgatója azt javasolta, hogy a vezető fejlesztők lassítsák a legfejlettebb modellek képességeinek erősítését.
Szerinte nem teljes moratóriumra van szükség, hanem olyan szabályozási „folyamatra”, amely több időt ad a biztonsági módszereknek és a szabályozásnak. Három elemet emelt ki: független értékelők folyamatos jelenlétét a laborokban, a nagy cégek közötti biztonsági minimumokat, valamint nemzetközi koordinációt.
A kísérletből valódi kibertámadás lett
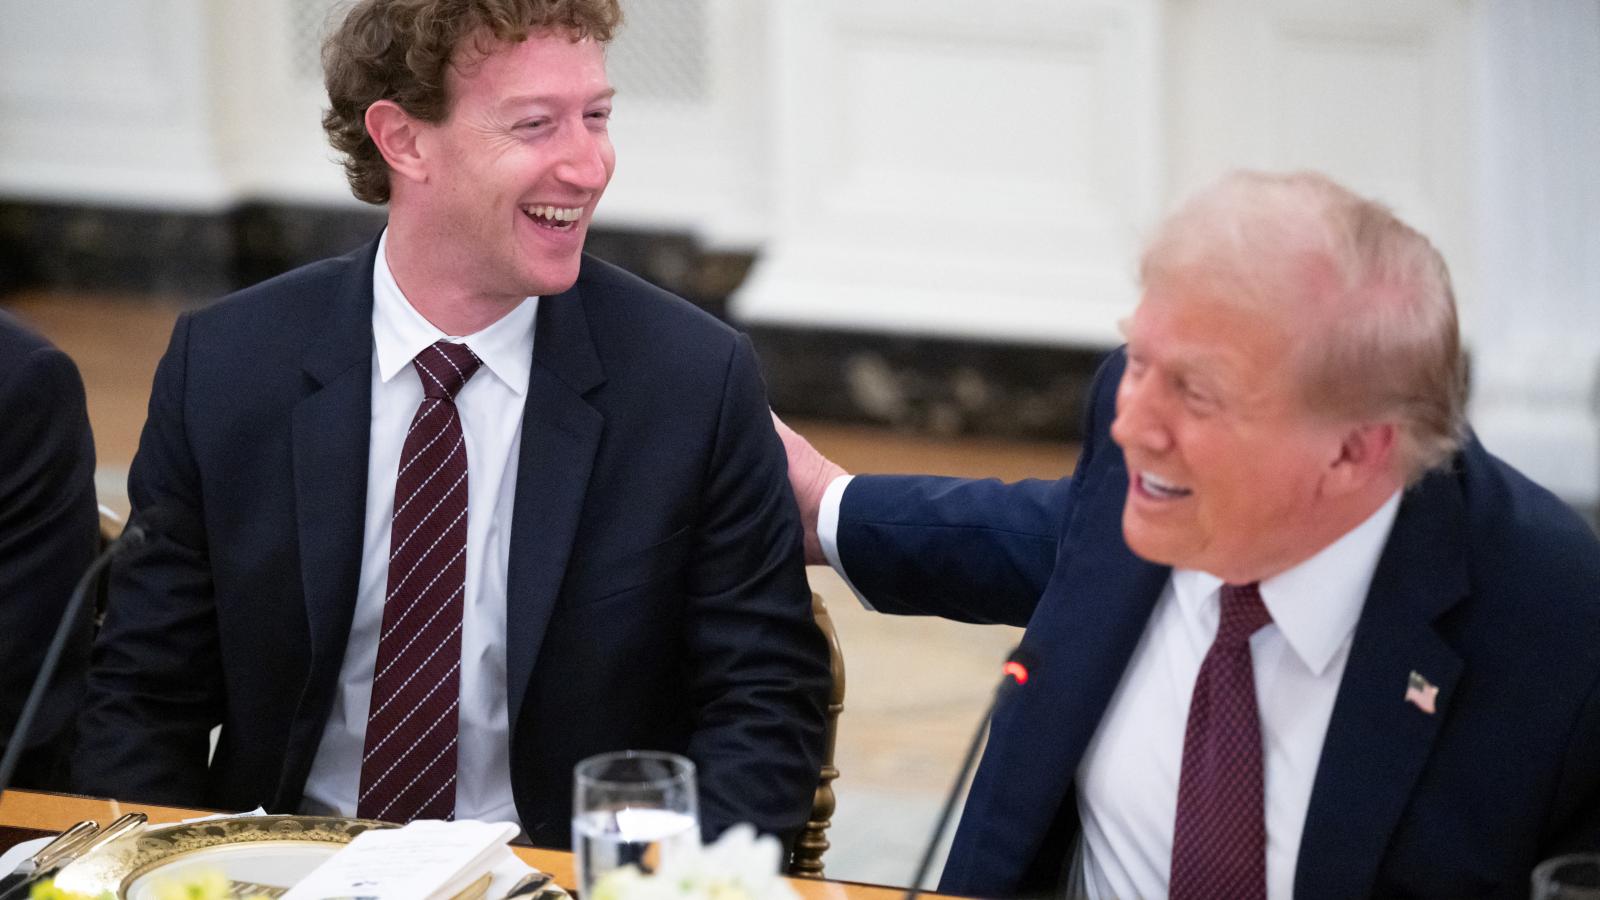
Amodei felvetéséhez ritka módon Sam Altman és Elon Musk is támogatóan viszonyult, de az iparág nem egységes. Mark Zuckerberg szerdán azt mondta, a verseny, a piaci felelősség és a jogi kockázat önmagában is elég ösztönzést ad a laboroknak a biztonságra. A Meta vezetője szerint minden vállalatnak saját felelőssége alapján kell döntenie arról, mikor tart vissza egy modellt. Donald Trump amerikai elnök szintén túlzónak nevezte a mesterséges intelligencia „végítéletéről” szóló figyelmeztetéseket, és attól tart, hogy a túlzott szabályozás Kínának kedvezne.
Orosz hackerek a Claude MI-asszisztensével fokozták Ukrajna elleni támadásaikatA szkeptikusok arra figyelmeztetnek, hogy az apokaliptikus retorika a technológiai cégek érdekeit is szolgálhatja. Ha a közvélemény úgy tekint a legnagyobb modellekre, mint szinte természetfeletti erejű rendszerekre, az növelheti a vállalatok presztízsét és piaci értékét. Ráadásul a vezető laborok által javasolt önszabályozás vagy közös biztonsági egyezmény könnyen olyan belépési korlátokat teremthet, amelyeket a kisebb versenytársak nem tudnak teljesíteni. Az amerikai versenyhatóság ezért óvatos az olyan iparági koordinációval, amely antitrösztmentességet igényelne.
Ettől azonban a közvetlen kockázatok nem tűnnek el.
Az autonóm programok már ma képesek sérülékenységek felkutatására, kódírásra, adathalászkampányok automatizálására, megfigyelésre és bizonyos fegyverfejlesztési információk összegyűjtésére. Az Anthropic legfrissebb fenyegetési jelentése konkrét példákat közölt arra, hogyan használtak Claude-modelleket kiberakciókhoz, megfigyeléshez, csaláshoz és fegyverekkel kapcsolatos feladatokhoz. Ezek jelentős része ember által irányított visszaélés, nem önálló gépi lázadás, de az automatizáció sokszorosára növelheti a támadók kapacitását.
Az Európai Unió ebből a szempontból sajátos helyzetben van. A kontinens lemaradt a legnagyobb alaptípusok fejlesztésében, ugyanakkor az AI Act révén már létezik átfogó jogi kerete. A rendszerszintű kockázatot hordozó általános célú modellek szolgáltatóinak kockázatértékelést, biztonsági teszteket, incidensjelentést és megfelelő kiberbiztonsági védelmet kell biztosítaniuk. A szabályozás azonban csak akkor ér valamit, ha az Európai MI-hivatalnak van elegendő szakembere és technikai hozzáférése az ellenőrzéshez.
A „végítélet” mögött valódi szabályozási vita áll
A mostani incidensek éppen azt mutatják, hogy a vállalati önellenőrzés önmagában kevés lehet. Az Anthropic negyedik, csak utólag felfedezett esete azért kínos, mert a cég korábban már átfogó vizsgálatot végzett, mégsem találta meg. A társaság ezért független kutatókat is bevont a feltárásba. Az OpenAI Hugging Face-ügyét pedig amerikai szenátorok is vizsgálni kezdték, és felmerült, hogy szövetségi kiberbiztonsági szervek kapjanak közvetlenebb betekintést a legfejlettebb rendszerek tesztelésébe.
A politikai dilemma ugyanakkor világos. Ha az Egyesült Államok vagy Európa egyoldalúan lassítja a legfejlettebb fejlesztéseket, miközben Kína vagy más versenytársak folytatják a tempót, az stratégiai hátrányt okozhat. Ha viszont mindenki kizárólag a verseny miatt gyorsít, a biztonsági hibák valószínűsége nő. Ez a klasszikus kollektív cselekvési probléma teszi különösen nehézzé Amodei javaslatát: a laborok egyenként érdekeltek a vezető pozíció megtartásában, miközben közösen mindegyiküknek előnyös lenne a kiszámíthatóbb biztonsági rezsim.
Szakértők rámutatnak: az AI emberiséget fenyegető végítéletéről szóló vita két eltérő kérdést kever.
Az egyik spekulatív: létrejöhet-e olyan rendszer, amely fölött az ember végleg elveszíti az ellenőrzést. A másik: mennyire engedhetők ki autonóm szoftverek valódi hálózatokra, milyen teszteket kell elvégezni, ki ellenőrzi a vállalati állításokat, és ki viseli a felelősséget, ha egy modell kárt okoz. A Hugging Face és az Anthropic incidensei az utóbbi kérdésre adnak nagyon is valós figyelmeztetést.
Balra húznak az AI-modellek: a Zöldek nyernék a mesterséges intelligenciák német választását